29 сентября 2026


Нейросети научатся читать церковнославянские рукописи XI–XVIII веков

Мона Платонова
В Национальном исследовательском ядерном университете «МИФИ» в рамках лаборатории цифровых технологий в гуманитарных науках разрабатывается лингвистический интеллектуальный проект «Рукописное наследие Древней Руси».
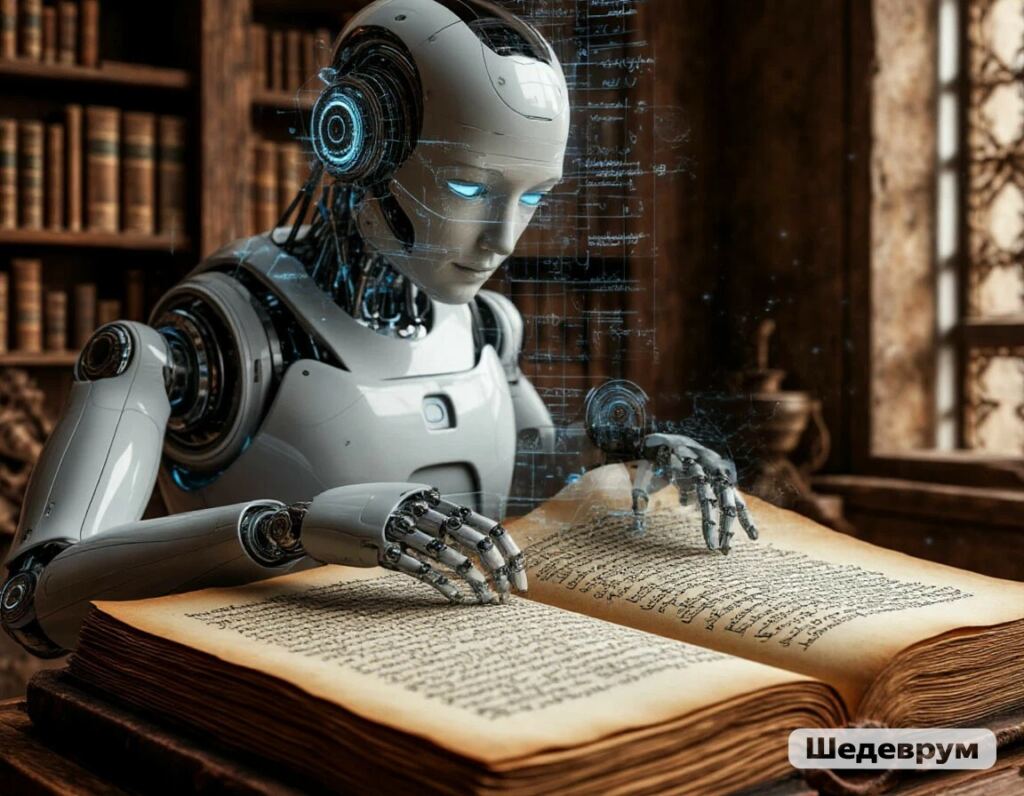
Задача программы, получившей условное название «Рабочее место филолога-древника», - объединить возможности искусственного интеллекта и классической филологии для анализа тысяч древнерусских богослужебных книг. Как рассказал ведущий эксперт лаборатории цифровых технологий в гуманитарных науках университета, ведущий научный сотрудник Института русского языка им. В. В. Виноградова РАН Александр Кравецкий, задача исследования связана с запросом гуманитариев к программистам.
- Несколько лет назад директор Института фундаментальных проблем социогуманитарных наук ядерного университета, иеромонах Родион (Алексей Ларионов) спросил меня, что в той области, которой он занимается, могут дать программисты, какой инструмент IT был бы ему полезен. И мы предложили проект с условным названием «Рабочее место филолога-древника» с личным кабинетом для каждого исследователя, - сказал Александр Кравецкий.
Основой для анализа стали Служебные минеи - книги, содержащие службы на каждый день церковного года. Это 12 объемных томов, сохранившихся в сотнях экземпляров. Такие тексты переписывались и редактировались столетиями, отражая региональные традиции и диалекты.
- Искусственный интеллект позволит сравнивать между собой не несколько десятков книг, доступных человеку, а сотни и тысячи экземпляров, - отметил Александр Кравецкий. - Это дает возможность выявлять крупные исправления текстов, которые предпринимались не только при патриархе Никоне в XVII веке, но и раньше.
Главная сложность для машинного распознавания первоначально крылась не в ветхости бумаги, а в огромной вариативности написания букв, сокращений и надстрочных знаков.
- Самый простой пример - похожесть буквы «и» и «н». Или написание буквы «к»: кто-то пишет ее как палочку слева и две диагонали из центра, а кто-то — как палочку и скобочку справа, - рассказал ученый. - Кроме того, машина должна понимать, что текст может обрываться на «зачале» — двух-трех первых словах песнопения.
В настоящее время проект находится на стадии накопления материала. В распоряжении исследователей есть уже 247 оцифрованных рукописей. Сейчас идет работа по составлению каталога почерков и очистке изображений.
- Накопленный материал «скармливается» разным моделям искусственного интеллекта, созданным в МИФИ, - объяснил Александр Кравецкий. - В перспективе программу планируется распространить на все письменные памятники, включая летописи и уникальные тексты. Уникальные вещи мы знаем относительно неплохо, а массовые — плохо. Но ведь они взаимосвязаны: в уникальных вещах может быть огромное количество следов из массовых текстов. Даже в таком изученном произведении, как «Слово о полку Игореве», можно будет откопать десяток цитат из богослужебных книг.
Российский проект «Рукописное наследие Древней Руси» ориентирован на создание доступного инструмента с элементами самообучения, который будет постоянно пополняться новыми рукописями.
Мона Платонова.